
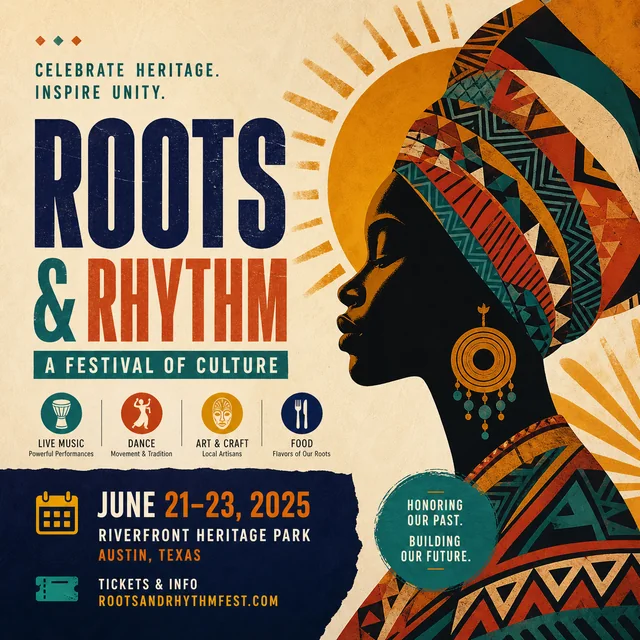
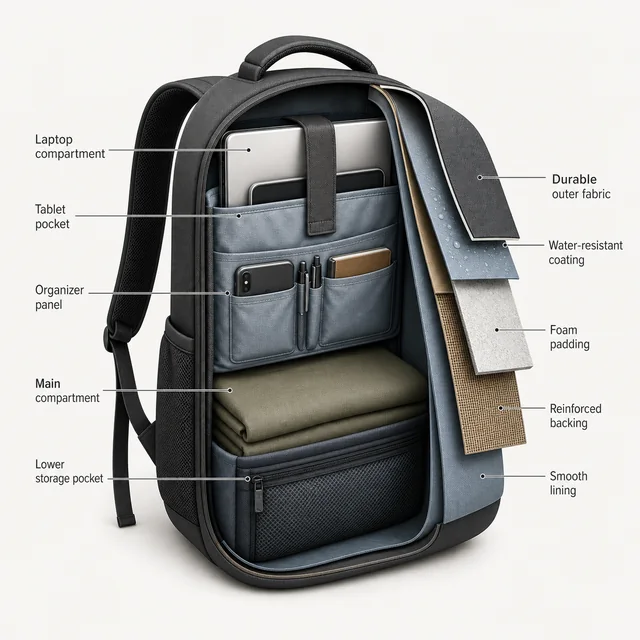
テキストから画像へのコントロール
自然言語で被写体、カメラ、背景、パレット、照明、雰囲気を指示します。
テキストプロンプトからオリジナル画像をオンラインで作成します。AIモデル、アスペクト比、出力数を選択して、高解像度のビジュアルを生成し、クリエイティブな作品に活用できます。
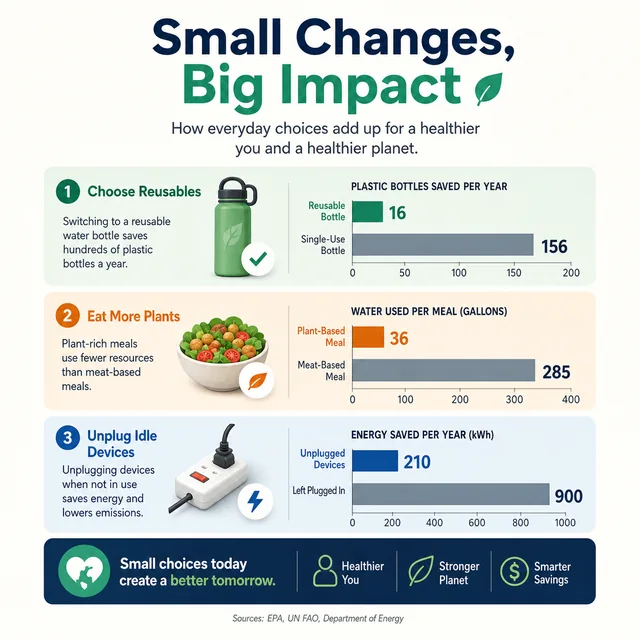
“構造化されたプロンプトから始め、被写体、シーン、照明、細部を調整します。”
“構造化されたプロンプトから始め、被写体、シーン、照明、細部を調整します。”
“構造化されたプロンプトから始め、被写体、シーン、照明、細部を調整します。”
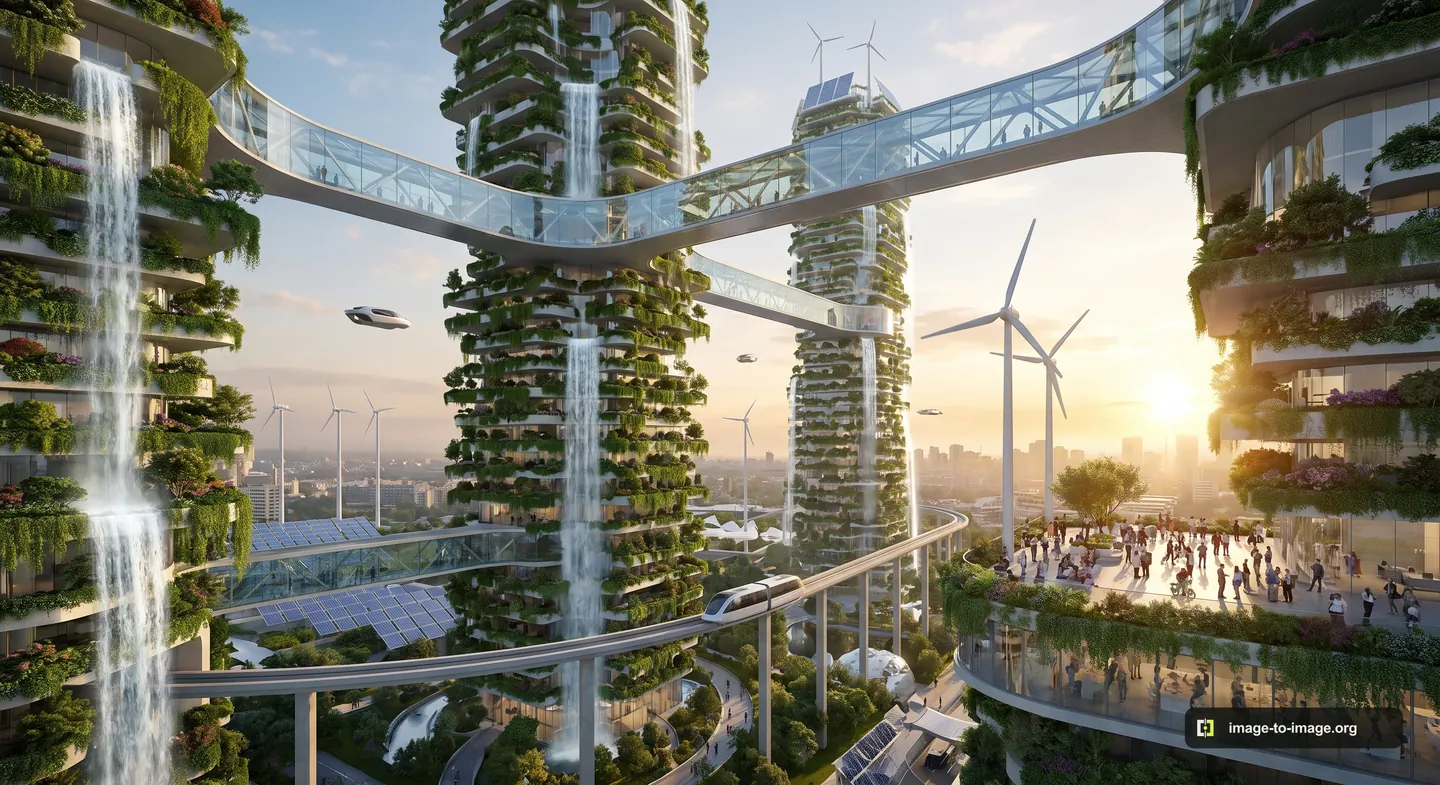
テキストから画像を生成するAIは、文章での説明を新しいビジュアルに変換します。アップロードされたソースを編集する代わりに、モデルはプロンプト内の被写体、背景、構図、照明、素材、スタイルを解釈して、ゼロから画像を作成します。
自然言語で被写体、カメラ、背景、パレット、照明、雰囲気を指示します。
各プロジェクトの速度、解像度、指示の遵守度、クレジットコストのバランスをとる。
ソーシャル、製品、編集、コンセプト作品のために、アスペクト比と出力数を選択する。
複雑な編集スイートの代わりに、1つの集中したワークフローを使用する。
制作前にビジュアルの方向性を探る。
オリジナルのキャンペーンおよびソーシャルメディアのビジュアルを作成します。
製品のアイデアを現実的なコンテキストに配置します。
被写体およびビジュアルの方向性を説明します。
モデル、比率、出力数を設定します。
最大4つの画像バリエーションを同時に作成します。
プロジェクトのために最も強力な結果をエクスポートします。
視覚的な詳細を追加する前に、主要な被写体とアクションを先に示します。
曖昧な品質の言葉を並べるのではなく、照明、レンズ、構図、媒体を説明します。
まず焦点を絞った最初のバージョンを生成し、その後1つずつ変数を改良します。
対象、設定、媒体、光、構図、そしてムードを明確な言葉で指定してください。
クレジット制でのエクスポートは、提供者の利用規約およびプロンプト入力権に従い、商業目的での使用が可能です。
はい。このページは文章によるプロンプトから始まり、アップロードされた参照画像は必要ありません。
汎用的なアセットには正方形、人物やポスターには縦長、景色、バナー、プレゼンテーションには横長を使用してください。
モデルによって、解像度、プロンプトへの従順性、ビジュアルの特徴、生成時間、クレジットコストが異なります。